2026年9月20日 下午 5:19
AI 設計AI MODELS · 2026
QUICK ANSWER
Jev 是 TypeSafe AI 於 2026 年 9 月 15 日推出的 AI 模型。它不會寫字,只會做三種題目:選擇題、評分題、是非題,而且每題都附上「有多確定」的信心分數。官方數據是不到半秒答完、每百萬輸入 token 0.042 美元、輸出免費,目前要排候補名單才能用。
這幾天 AI 工程圈都在傳一顆模型,它連一個字都寫不出來。
不會聊天,不會寫程式,不會幫你摘要會議紀錄。你丟一段內容給它,再給它幾道題目,它只會做三件事:從選項裡勾一個、在量表上打個分數、回答是或否。
最接近的比喻是急診室的檢傷護理師。她不開藥、不動刀,只用幾十秒判斷你該去哪一區、要不要馬上處理。醫院需要她,因為不可能讓每個走進來的人都先給主治醫師看十分鐘。ChatGPT、Claude 這些會寫字的模型是醫師,Jev 是檢傷站。
做出這顆模型的人叫 Diogo Almeida,前 OpenAI 研究員。TypeSafe 官網寫他是 RLHF 的共同發明人,RLHF 就是當年讓語言模型學會聽懂人話、後來訓練出 ChatGPT 的那套方法。教會 AI 說話的人,隔了幾年回來做一顆不說話的 AI。
我把官方發表文、技術文件、評測網站,連同他們自己列的弱點清單全部讀完了。這篇盡量不用工程師的語言,講清楚四件事:它是什麼、為什麼有人需要它、設計師為什麼要懂、官方的漂亮數字該怎麼看。
CONTENTS
01
一顆只會答選擇題的模型
02
AI 代理的每一步,幾乎都是一次判斷
03
三種題型,一次問完
04
設計師為什麼要懂它
05
官方數字怎麼讀
06
官方自己列的弱點清單
07
怎麼拿到、多少錢
08
不說話的那一層
CHAPTER 01 · WHAT IT IS
TypeSafe AI 是一間新的 AI 實驗室,由 Diogo Almeida、Sasha Sheng、Erik Gafni 三人創辦,低調做了兩年,9 月 15 日連同 DCVC 領投的 4,000 萬美元種子輪一起公開。Jev 是他們第一顆對外的模型,目前要排候補名單才能試用。
先講它跟 ChatGPT 差在哪。你問 ChatGPT 一個問題,它回你一段話。對人來說這很好,對程式來說卻很麻煩。假設你的客服系統想知道「這封信該轉給哪個部門」,它要的只是「帳務」兩個字,語言模型卻可能回你:「好的,根據信件內容,我認為這封信應該轉交帳務部門處理,原因如下」。程式得從這一大段話裡把「帳務」挖出來,還得提防它哪天回了一個公司根本沒有的部門。
Jev 的做法是乾脆不讓模型寫字。你先把選項列好:帳務、技術、業務、以上皆非。它只能從這四個裡面勾一個,連寫出第五個答案的機會都沒有。考過試的人都懂這個差別:申論題可以離題,選擇題頂多選錯。
▲ 整理自 TypeSafe 官方發表文。大型語言模型一欄為官方引用的前沿模型區間
表裡的 token 是 AI 模型計算用量的單位,可以粗略想成字數。
兩個名字都有出處。System One 來自康納曼《快思慢想》裡的系統一,指的是快、直覺、幾秒內做完的判斷;現在主流的推理模型走的是系統二,慢、深思、一步一步推。Jev 則取自十九世紀經濟學家 William Stanley Jevons,傑文斯悖論那位:蒸汽機變得更省煤之後,煤的總用量反而暴增。TypeSafe 賭同樣的事會發生在 AI 上,判斷每便宜十倍,用得到它的地方就多出不只十倍。
CHAPTER 02 · WHY IT MATTERS
Almeida 的發表文用一個問題開場:模型在聊天這件事上,好幾年前就超越人類了,那自動化都跑去哪了?
他的答案是工具拿錯了。現在流行的 AI 代理,指的是能自己連續做好幾步的 AI,像 Claude Code 或 Figma Agent。把它實際在做的事攤開來看:這封信該轉給哪個部門、這份文件屬於哪一類、這段輸入安不安全、下一步該用哪個工具、這件事要不要交給真人。這些步驟大多是判斷,真正需要寫字的,常常只有最後回覆的那一步。
我們卻一直請醫師來做檢傷。每個小判斷都交給一顆為了寫字而訓練的大模型,每一步都要等它把話講完,每一步都照字數收錢,每一步都有機率回你一個不存在的選項。
讀過我寫的 Loop Engineering 的人,對這個結構應該不陌生:迴圈要自己觸發、自己驗證、自己決定下一步,裡面每一個「決定」都要問模型一次,迴圈跑得越勤,帳單越難看。Harness Engineering 那篇講的驗收清單也一樣,每一條檢查都是一次判斷。
TypeSafe 的文件跟團隊頁都掛著同一句話:Build prod, not God,做產品,不做神。他們沒打算做一顆什麼都會的模型,只想把又小、又窄、量又大的判斷做到又快又便宜。官方預期未來大規模的 AI 自動化裡,99% 是機器跟機器之間的往來,只有 1% 需要跟人對話。
70–500
回應時間 · 毫秒
$0.042
每百萬輸入 TOKEN
$0
輸出 TOKEN
255
單題選項上限
▲ Jev 1.13 的官方規格,數字取自 TypeSafe 官方文件 Models 頁
速度跟價格最容易被轉傳,但我覺得真正重要的是另一件事:它每一題都會附上自己有多確定。這個留到第四章講。
CHAPTER 03 · HOW IT WORKS
它只會三種題目。名字有點怪,概念你都很熟。
Choice 是選擇題,最多可以放 255 個選項。它會告訴你選了哪個、每個選項各有幾成機率,以及整題的信心分數。官方建議永遠多放一個「以上皆非」,不然它只能硬選一個最接近的錯答案。
Score 是評分題。你用文字描述二到十個等級,例如「冷靜陳述事實」「不滿但有禮貌」「非常憤怒」,它回傳的分數可以落在兩級中間,像 1.4,意思是比「不滿但有禮貌」再氣一點。
Noul 是是非題,回傳一個 0 到 1 之間的數字,代表答案為「是」的機率。0.97 就是它有九成七的把握。
ANATOMY OF ONE CALL · 一次呼叫長這樣
STATE · 你給它的內容
「這已經是我這個月第三次被重複扣款了,訂單 A-104。請把多扣的那筆退給我。」
QUESTIONS · 三題同時作答,各自回傳
CHOICE
這張工單該交給哪個部門?
帳務
帳務
0.94
技術
0.04
以上皆非
0.02
信心分數 0.91
SCORE
客戶有多不滿?
1.20
0 · 冷靜陳述事實
0.05
1 · 不滿但有禮貌
0.70
2 · 非常憤怒
0.25
落在等級 1 跟 2 之間
NOUL
客戶明確要求退款?
0.97
答案為「是」的機率
0.97
是非題不另外回傳信心
▲ 示意圖:題目與數值為說明用,並非實測結果。回傳欄位依 TypeSafe 官方文件繪製
你給它的那段內容,官方叫 state,可以是一段文字、一串對話紀錄,或是整理好的資料。它把內容讀一次,所有題目同時作答、互不干擾,所以多問十題幾乎不會變慢,只多一點點錢。
這跟我們用 ChatGPT 的習慣相反。用 ChatGPT 你會先問一個問題,看了答案再追問;用 Jev,官方建議把可能用得到的問題一次問完,事後再決定要採用哪些答案。官方示範拿一篇很長的維基百科條目問了十三個問題,一次問完比一題一題問便宜 12.2 倍、快 10 倍,答案完全相同。
最後講信心分數為什麼可信。一般語言模型你也可以問它有多確定,但它給的數字通常不準,而且偏向過度自信。TypeSafe 為 Jev 設計了一套新的訓練方法,官方叫 RLCD,訓練目標只有一個:機率要準。道理跟氣象預報一樣。預報說降雨機率 70% 的那些日子,如果十天裡真的有七天下雨,這個預報就算準。Jev 說有八成把握的那一批答案,事後答對的比例就該接近八成。官方也特別註明,這講的是一整批答案的統計,不保證某一題一定對。
CHAPTER 04 · FOR DESIGNERS
你大概不會自己去用 Jev,它是工程師放在產品裡面的零件。但它改變的幾件事,最後都會落到設計師的桌上。
過去 AI 功能的介面只有兩種狀態:AI 回了,或是還沒回。模型有多確定,介面上看不到,因為模型自己也講不準。現在信心變成一個可以拿來訂規則的數字。官方文件舉了語音銀行的例子:使用者用講的操作帳戶,系統先判斷他想做什麼,再依照做錯的代價,決定要多有把握才動手。
CONFIDENCE GATES · 同一個判斷,四種畫面
任何動作
< 0.6
轉給真人客服
模型真的不確定,不管它猜的是哪個動作,一律不自動處理。
查詢餘額
≥ 0.6
直接顯示餘額
唯讀、低風險。猜錯的最壞結果,是使用者多聽了一次餘額。
核准轉帳
0.6–0.85
先跳出確認
會動到錢,信心普通。把判斷結果唸給使用者聽,請他確認後再執行。
核准轉帳
> 0.85
自動執行
高風險加上高信心,才允許系統不問就做。
▲ 整理自 TypeSafe 官方文件的語音銀行範例,門檻為官方示範數字,實際產品要依風險自己調
這段規則工程師會寫。但門檻該設多少、沒過門檻時畫面長什麼樣、確認框要怎麼問才不煩,全部是互動設計的題目。以後畫 AI 功能的設計稿,除了一切順利的主流程(happy path),還得多畫兩種狀態:AI 不太確定,跟 AI 很不確定。
“
AI 有多聰明是工程問題。AI 不確定的時候畫面長什麼樣,是設計問題。
官方把即時應用列為主要場景之一,講的是 150 毫秒等級的回應,比人的感知還快。LLM 的延遲以秒計,所以 AI 功能一直被設計成「按下去、等一下、看結果」。當判斷只需要零點幾秒,它就可以發生在打字的當下、拖曳的當下、表單送出前的那一瞬間。例如輸入框即時判斷這句話該走搜尋、走客服還是走指令,使用者不必自己先選分頁。官方拿 Jev 玩 Doom 的 demo 也是同一個意思:每秒問十次,一小時大約 7 美元。
TypeSafe 列的使用情境裡,有幾項是設計團隊每天在做的事:替訪談逐字稿跟開放式問卷的回答貼上預先定好的主題標籤;檢查廣告素材、文案跟到達頁講的是不是同一件事;拿團隊自己的寫作規範去掃文案。這些工作的共通點是答案空間固定、量大、重複,現在要嘛人工貼,要嘛丟給 LLM 慢慢跑。
發表第一週,開發者 Hassan El Mghari 拿它分類了 1,018 篇論文。他自己公布的帳單是:用生成模型寫摘要花 3.99 美元,用 Jev 分類花 0.08 美元。
官方的弱點清單裡有一條跟設計師特別有關:Jev 讀語意比讀數字好。拿 hex 色碼或 RGB 數值問它兩個顏色接不接近,它答不準,換成顏色名稱就好很多。官方的建議是數值換算留在程式裡,模型只負責真正屬於判斷的那一段,例如這個顏色看起來像不像警告。
CHAPTER 05 · THE NUMBERS
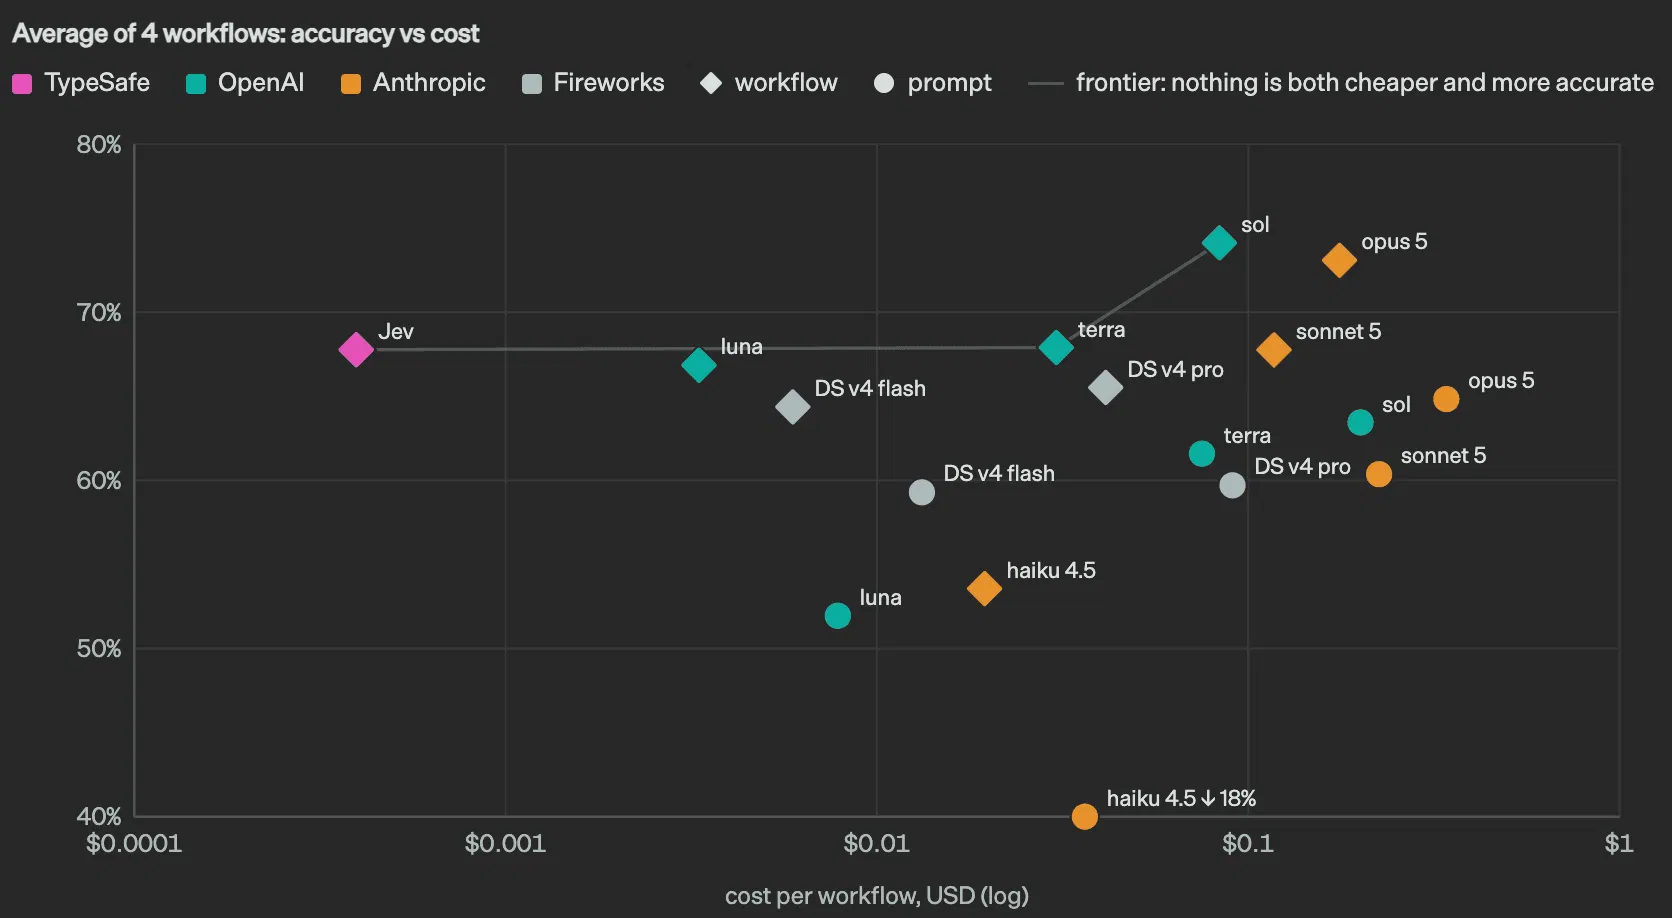
這張圖是 TypeSafe 自己辦的一場考試。考題是四種常見的自動化工作:處理資安警報、監看 AI 代理的工作紀錄、處理發票、客服。橫軸是答一題要花多少錢,越左邊越便宜;縱軸是分數,越上面越高。
結論先講:Jev 拿到 67.8%,跟 GPT-5.6 Terra 的 67.9%、Claude Sonnet 5 的 67.8% 幾乎同分,輸給 GPT-5.6 Sol(74.1%)跟 Claude Opus 5(73.1%)五到六個百分點。但 Jev 答一題只要 0.0004 美元、0.4 秒,Sonnet 5 要 0.1174 美元、78.1 秒。同樣的分數,便宜將近三百倍,快將近兩百倍。
數字很漂亮,但有三件事要一起看。
第一,這場考試沒有標準答案。評分方式是看你跟兩位最貴的學霸答得像不像,這兩位是 GPT-6 Astra 跟 Claude Fable 5.1。所以縱軸量的其實是「跟頂級模型有多一致」。官方自己也承認,這種算法對 OpenAI 跟 Anthropic 的模型比較有利。
第二,出題、監考、改考卷的都是 TypeSafe 自己,目前沒有第三方完整重做一次。官網首頁主打的快 193.6 倍、便宜 444.6 倍就出自這場考試,發表文也承認這大概是實際效益的上限。
第三,圖上每顆模型都有兩個點。菱形是把一件大事拆成很多小題目來問,圓形是把所有規則塞進一大段指令、讓模型自己想。每一顆模型的菱形都比自己的圓形更準、更便宜、更快。這一點跟 Jev 無關,卻是整張圖最實用的一課:把判斷拆小,任何 AI 都會變準。你下次寫 prompt 也適用。
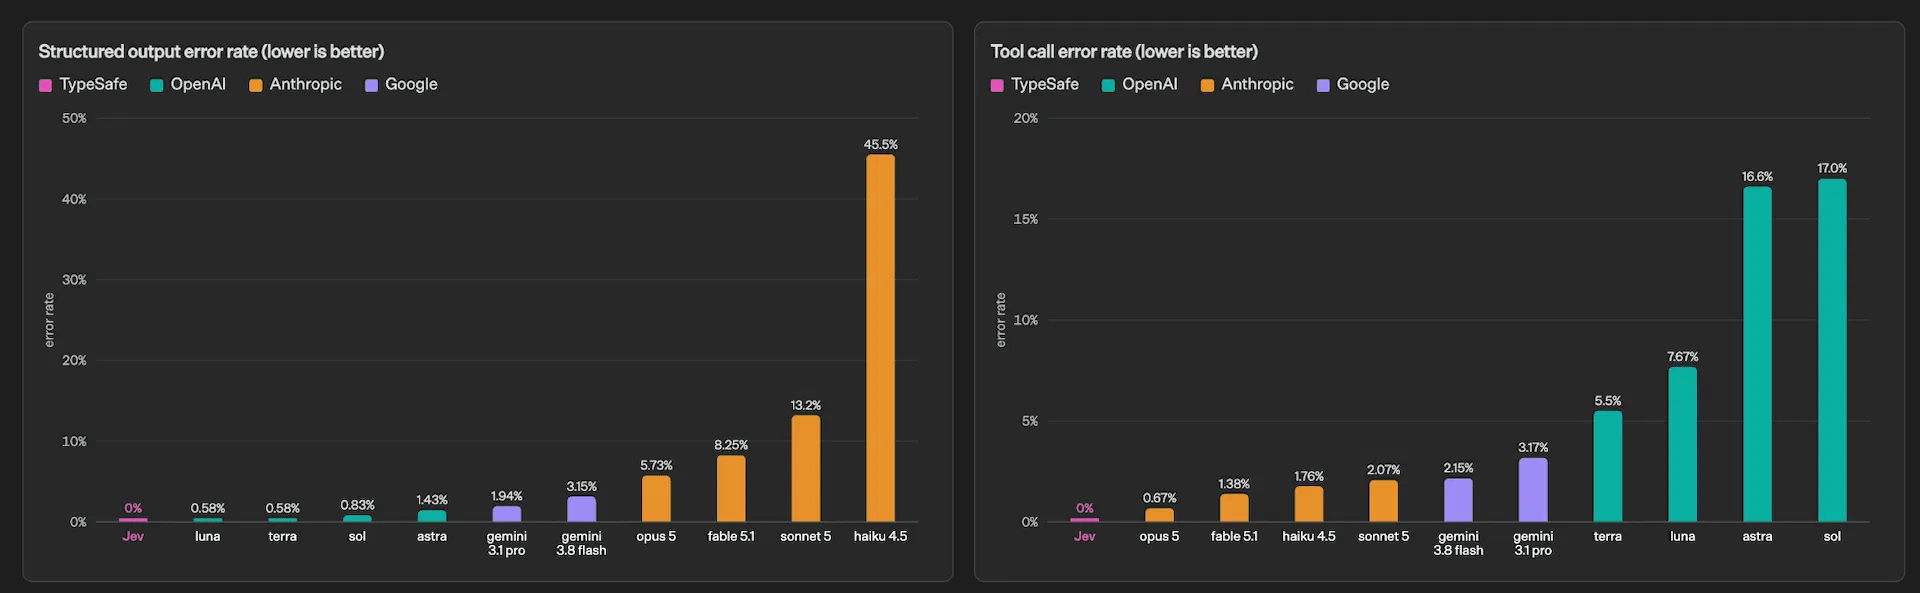
第二張圖是「Jev 不會幻覺」這個說法的來源。兩張長條圖比的都是 AI 交出來的答案格式有沒有錯,例如叫它從清單裡選一個工具,它卻選了清單上沒有的。Jev 兩邊都是 0%。
這個 0% 要讀仔細。回到選擇題的比喻:選擇題不可能寫出第五個選項,所以亂寫的機率天生是零,官方也註明這個數字是設計上的保證,沒有經過實測。但選擇題照樣會選錯。「不會幻覺」講的是前者,跟「不會出錯」是兩回事。另外,其他模型的數字取自 OpenRouter 平台的統計,官方提醒裡面幾乎一定有偏差;圖上最嚇人的 45.5% 是 Claude Haiku 4.5 一顆的特例,其餘模型都在 0.58% 到 13.2% 之間。
至於價格,官方說他們沒辦法證明這個定價沒有靠補貼,只表示預期會繼續往下走。
CHAPTER 06 · LIMITS
TypeSafe 做了一件發表週很少見的事:在文件裡放了一頁清單,列出 Jev 目前做不好的九件事。我挑跟實際使用最相關的七項,翻成白話。
▲ 整理自 TypeSafe 官方文件 Jev 1.13 jaggedness 頁,該頁最後檢視日期為 2026 年 9 月 17 日
清單以外還有幾個硬限制。它只吃文字,圖片、聲音、影片都得先轉成文字。一次能讀的內容上限是 64k token,大約幾萬字,比主流語言模型小很多。流量限制會隨著機房擴充隨時調整,官方明講可能不另行通知。
最後一個對台灣讀者最重要。Jev 以英文為主要訓練語言,官方文件寫得很直接:包含中日韓文字在內的其他語言能處理,但表現沒有英文好,建議上線前用自己的內容測過,分流時特別留意信心分數。想拿它處理中文客服、中文逐字稿,這一步不能省。
CHAPTER 07 · GETTING ACCESS
Jev 目前是 early access,要到 TypeSafe 官網排候補名單,通過後才拿得到金鑰。另一個入口是 Vercel AI Gateway,模型目錄裡已經有 Jev。
價格只算你送進去的內容:每百萬 token 0.042 美元,它回答的部分不收錢。官方那場考試裡,平均答一題大約 0.0004 美元,也就是一塊美金可以問兩千五百題。官方也說明,客戶送進去的內容不會被拿去訓練模型;它不提供客製訓練,想讓它懂你的領域,做法是把規則寫進題目、把資料一起送進去。
不會寫程式也有路。如果你平常用 Claude Code 或 Codex,TypeSafe 有官方的 agent skill,裝好之後可以直接請 AI 幫你把 Jev 接起來。對設計師來說這可能是最實際的入口:你負責把判斷拆成題目、定義選項跟門檻,程式交給 AI 寫。
順帶一提,TypeSafe 的官網是用 Framer 架的,做前沿模型的團隊也沒有自己從頭刻網站。
Almeida 七月底在 AI Engineer 的演講,把他為什麼離開原本那條路講得很完整。影片是英文、內容偏技術,想深入的人可以看。
▲ TypeSafe 創辦人 Diogo Almeida 在 AI Engineer 頻道的演講〈Jev Creator: Why RLCD beats RLHF〉
CHAPTER 08 · TAKEAWAYS
TAKEAWAYS
→
Jev 不會寫字,只會答三種題目:選擇題、評分題、是非題,每題附上它有多確定。
→
把它想成急診的檢傷站:又快又便宜地把事情分好類,困難的再交給會寫字的大模型。
→
官方數據是不到半秒、每百萬輸入 token 0.042 美元、輸出免費。考試是官方自己辦的,比的是跟頂級模型答得像不像。
→
「不會幻覺」的意思是不會寫出選項以外的答案,照樣可能選錯。中文表現官方明講比英文弱,上線前要自己測。
→
對設計師最實際的兩件事:AI 功能的設計稿要開始畫「不確定」的狀態;把模糊的判斷拆成一題一題的小問題,任何 AI 都會變準。
讀完所有資料,我最大的感想跟模型本身關係不大。
過去兩年談 AI,談的幾乎都是會說話的那一層:寫得好不好、畫得像不像、聊起來自不自然。Jev 提醒的是底下還有一層,不說話、沒有介面、一天可能被呼叫幾百萬次,負責決定每一則訊息往哪走、每一個動作要不要放行。
Almeida 對媒體形容 Jev 比較像資料庫,不像同事。沒有人在乎資料庫的個性,大家在乎的是架在它上面的產品用起來怎麼樣。
這一層越便宜,就會被放進越多產品裡。而使用者唯一感覺得到它的時刻,是它不確定、畫面必須做出反應的那一秒。
那一秒長什麼樣,是設計師的工作。
RELATED READS · 延伸閱讀
EXTRA · LINKS 官方資源
FAQ
A:Jev 是 TypeSafe AI 於 2026 年 9 月 15 日推出的 AI 模型。ChatGPT、Claude 會寫字,Jev 完全不寫字,只針對你事先列好的題目回答選項、分數或是非,並附上信心分數。它是給程式用的零件,沒有聊天介面。
A:名稱來自康納曼《快思慢想》的系統一,指快速、直覺的判斷。TypeSafe 用它稱呼一類專門替軟體做快速判斷的模型:讀進一段內容,針對固定的題目同時作答,不做長篇推理,也不產生文字。Jev 是第一顆公開的 System One 模型。
A:每百萬輸入 token 0.042 美元(每十億 token 42 美元),輸出不收費。目前為 early access,需到 TypeSafe 官網登記候補名單,通過後取得 API 金鑰;Vercel AI Gateway 的模型目錄也已上架。
A:它不會寫出你沒列的答案,就像選擇題不可能寫出第五個選項,官方圖表上的 0% 是這個設計帶來的保證,並非實測數據。但它仍然可能選錯,所以官方建議搭配信心分數設門檻,把握不夠的案例轉給真人或更強的模型。
A:可以輸入中文,但官方文件明寫英文是主要訓練語言、準確度最好,包含中日韓文字在內的其他語言表現較弱。官方建議上線前用自己的內容測試,並在分流時特別留意信心分數。
A:多數設計師不會直接使用它,但會遇到它帶來的設計題目:AI 功能需要畫出「不確定」時的介面狀態,零點幾秒的判斷也可以放進即時互動。設計團隊本身也有適合的工作,例如替訪談逐字稿貼主題標籤、檢查文案是否符合寫作規範、比對廣告素材與到達頁是否一致。
A:不會,兩者分工不同。官方建議的做法是接力:Jev 先做便宜的分類與分流,程式能解決的交給程式,只有真正困難或需要寫字的少數案例才交給大型語言模型。