2026年9月22日 下午 7:54
AI 設計AI TOOLS · 2026
QUICK ANSWER
Claude Opus 5.5 是 Anthropic 2026 年 9 月 22 日推出的 5.5 家族首發模型。大部分工作跟 Fable 5.1 同級,一般工作量成本比 Opus 5 少 40%、輸出快 30% 以上,寫作改成重點先講、照你的規則寫。Pro、Max、Team 可用,API model ID 為 claude-opus-5-5。
台灣時間 9 月 23 日凌晨十二點半,Anthropic 把 Claude Opus 5.5 推上線。官方公告第一段就把話說完:大部分工作追平 Fable 5.1,跑起來比 Opus 5 便宜四成。發文沒多久,官方帳號的串文底下已經有人在問:那 Fable 還要賣那麼貴幹嘛?
這個問題問到重點了。新旗艦通常只會越出越貴,這一顆反過來:每百萬 token 的單價降了兩成,完成同一件事用掉的 token 也變少,兩個效果疊在一起,才疊出那個四成。
我把官方公告、平台文件跟二十一則早期測試者的回饋讀完,對設計師最有感的一段反而藏在價格後面:寫作。官方把「它寫的東西比較好讀」列成這次的主打,甚至說這件事在安全上也有意義。這句話我會在第五章拆開來講。
這篇依序講七件事:它在家族裡的位置、四成是怎麼省出來的、跑分該怎麼讀、早期測試者拿它做了什麼、寫作到底改了什麼、防護與限制,以及你現在該怎麼用。
CONTENTS
01
一顆追平 Fable 的 Opus
02
更強了,為什麼還更便宜
03
跑分要怎麼讀
04
早期測試者拿它做了什麼
05
這次最被低估的升級:寫作
06
防護、限制與破壞性變更
07
現在怎麼用、該不該換
08
一分鐘懶人包
CHAPTER 01 · WHAT IT IS
先把位置擺好。Claude 家族目前從上到下是 Mythos、Fable、Opus、Sonnet、Haiku。Mythos 只開放給通過審核的組織,Fable 是最強的公開等級,Opus 是日常主力,Sonnet 跟 Haiku 負責量大、要快的工作。
Opus 5.5 是新的 Claude 5.5 家族裡第一個上場的模型,Sonnet 5.5 跟 Haiku 5.5 官方說會在接下來幾週跟上。它最重要的定位只有一句:大部分工作的表現,跟 Fable 5.1 同一個等級。
這句話改掉了選模型的預設答案。七月我寫 Opus 5 拆解 的時候,結論是「日常用 Opus、重砲留給 Fable」;九月初寫 Fable 5.1 值不值得升級 時,官方文件也還是這個建議。現在同一份文件改成:不確定用哪顆,就先從 Opus 5.5 開始;Fable 5.1 留給高難度推理、長時程的代理任務,或是 Opus 5.5 開到高 effort 還不夠的時候。
重砲還在,只是出場的次數會少很多。
CLAUDE LINEUP · 2026.09
MYTHOS 5.1
最高階,只開放給通過審核的組織
FABLE 5.1
最強的公開模型,留給高難度推理與長時程代理任務
$10 / $50 · 預設 effort high · 較慢
OPUS 5.5 · NEW
新的日常主力,大部分工作追平 Fable 5.1
$4 / $20 · 預設 effort medium · 中等
SONNET 5
速度與智慧的平衡
$2 / $10 · 快
HAIKU 4.5
最快、最便宜
$1 / $5 · 最快
價格為每百萬 token 輸入/輸出(美元)。Sonnet 5.5、Haiku 5.5 官方表示將在未來幾週推出。資料來源:Claude 平台文件。
官方頻道的發表影片很短,重點都在說明欄:大部分工作追平 Fable 5.1、寫得更清楚、比 Opus 5 更快更有效率,以及為了慶祝上線調高了付費方案的額度。
▲ Claude 官方 YouTube 頻道的 Opus 5.5 發表影片
CHAPTER 02 · THE PRICE
四成這個數字,是兩件事乘出來的。第一件是單價:輸入從每百萬 token 5 美元降到 4 美元,輸出從 25 美元降到 20 美元,各降兩成。第二件是它做同一件事用的 token 變少了。官方的說法是,Opus 5.5 本身就比 Opus 5 省運算,定價只是反映這件事。
−40%
TYPICAL COST
一般工作量成本
30%+
OUTPUT SPEED
輸出速度提升
−20%
TOKEN PRICE
輸入、輸出單價
−60%
CACHE READ
快取讀取單價
降最多的是 cache read,從 0.5 美元砍到 0.2 美元。官方特別註明,cache read 占了代理任務跟寫程式工作的大部分成本。你在 Claude Code 或 Cowork 裡讓它跑一整個下午,模型會一直重讀同一批檔案跟對話,帳單上最大的那一塊就是這一格。
每百萬 token 價格(美元)。資料來源:Anthropic 官方公告、Claude 定價頁。
更狠的是檔位。Opus 5.5 在 API 上的預設 effort 從 Opus 5 的 high 降到 medium,而官方的效率圖裡,medium 已經打得贏別人開到最高檔。寫程式的 FrontierCode 評測,預設檔位拿到 54.6%,超過 GPT-6 Astra 的最高分,每個任務的成本大約五分之一;CursorBench 上比 GPT-5.6 Sol 的最高分多 11 分,成本約三分之一;知識工作的 GDPval-AA,預設檔位同樣贏過 Astra 開到 max,成本也只要五分之一左右。
付費訂閱的人看不到單價,但省下來的運算會變成額度。這次官方同步調高了 Pro、Max、Team 方案的五小時用量上限,還送每個訂閱用戶一次額度重置,可以先存著,哪天卡關了再自己挑時間用。
趕時間的話,Claude Code 跟 Claude Platform 上還有 Fast mode,速度最高快 2.5 倍,價格是每百萬 token 輸入 8 美元、輸出 40 美元,等於花兩倍的錢買時間。
CHAPTER 03 · BENCHMARKS
官方跑分表上,Opus 5.5 在代理式寫程式、電腦操作跟知識工作三個領域都拿第一,公告直接稱它是目前領先的模型。先看數字,再看三個讀法。
Opus 5.5 以 max effort 測試(Terminal-Bench 4.0 為 xhigh),Humanity's Last Exam 與 Chartography 為可使用工具的條件,OSWorld 2.0 官方標註 partial。白字為 GPT-6 Astra 領先的項目。資料來源:Anthropic 官方公告。
第一,官方自己提醒你別全信這張表。公告裡有一段很少見的話:到了這個能力等級,跑分上的差距越來越不能代表實際使用的差距;在他們自己的使用裡,Opus 5.5 跟 Fable 5.1 的差距比分數顯示的還小。翻成白話:表上它贏 Fable 一大截,實際用起來兩者很接近。開頭那句「大部分工作追平 Fable 5.1」,就是官方選了比較保守的說法。
第二,它也有輸的格子。GPT-6 Astra 在 AutomationBench(跨多個 App 跑商業流程)跟 Terminal-Bench-Science(代理式科學研究)兩項比較高。AutomationBench 是 Zapier 自己跑的,沒開備援模型,防護一介入就直接算失敗,官方說實際表現會比這個分數好。如果你的工作是大量串接 SaaS 的自動化流程,兩家都該拿真實任務比一次,GPT-6 Astra 的完整拆解我寫過了。
第三,防護會把分數往下拉。這張表是開著正式防護測的。防護一介入,資安題會交給 Opus 4.8、生物與前沿模型開發的題目交給 Opus 5 回答,官方說這很可能讓 Opus 5.5 的分數偏低。
設計師最該看的是倒數第二行的圖表判讀。平台文件寫得很具體:Opus 5.5 不靠工具,就能更精準地從密集的圖表、跟版面有關的視覺裡讀出數值,以前為舊模型寫的看圖技巧可能用不到了,只有最密集的圖還建議搭配圖片工具。儀表板截圖、數據報表、密密麻麻的設計稿,這一代可以先直接丟給它試試看。
CHAPTER 04 · IN PRACTICE
官方公告加上二十一則合作夥伴回饋,拼起來是一顆很有個性的模型:做得久、做得省,做完比較不用返工。
有測試者用它在不到一天內完成 68 萬行程式碼的遷移,官方說那原本是一整個工程團隊好幾週的工作。另一位測試者讓它稽核並修好一個 20 萬行的 codebase,花不到三小時;同一件事 Opus 5 跑了超過 20 小時,用掉 2.5 倍的 token。
Clio 的工程師更乾脆,把橫跨六個 repo 的任務丟給它,整晚不看。它連續工作超過 18 小時,每個里程碑都比 Opus 5 更早到,幾乎不用返工。
OPUS 5
38 次指令
來回 4 天
→
OPUS 5.5
11 次指令
3 小時完成
Quantium 的同一個複雜程式任務。資料來源:Anthropic 官方公告。
數據公司 Quantium 在 Chat、Cowork、Claude Code 三個介面都測過。一個原本要下 38 次指令、來回四天的複雜程式任務,換成 Opus 5.5 只要 11 次、三小時,產出也更接近可以直接上線的狀態。他們的說法是:團隊少花時間來回修,多花時間質疑假設、壓力測試結果。
遊戲。有測試者讓幾個 Claude 模型各用一句 prompt 做一款遊戲,Opus 5.5 拿到最高分,加分的地方是畫面跟完成度。
簡報。官方讓 Opus 5.5 跟 Opus 5 分析一樁虛構的併購案,先在 Excel 建財務模型,再做成給高層看的簡報。兩個模型結論一樣,但 Opus 5.5 的模型比較完整、簡報比較好讀,Opus 5 則有幾個小錯;Opus 5.5 花 63 分鐘、Opus 5 花 93 分鐘,成本少一半。金融 AI 公司 Rogo 也提到,它做的投影片資訊密度更高,更貼近業界的標準。
做網站。AI 建站工具 Lovable 的技術長說,換成 Opus 5.5 之後品質不變、速度更快:它會一次把脈絡讀完,修改次數更少也更完整,不會卡在重試迴圈,步驟少了三分之一到一半。
發表當下,Claude 官方 YouTube 頻道還同時上了四支示範影片。影片說明沒有標註用的是哪個模型,所以我不把它們算進 Opus 5.5 的戰績,但其中兩支很適合設計師看。
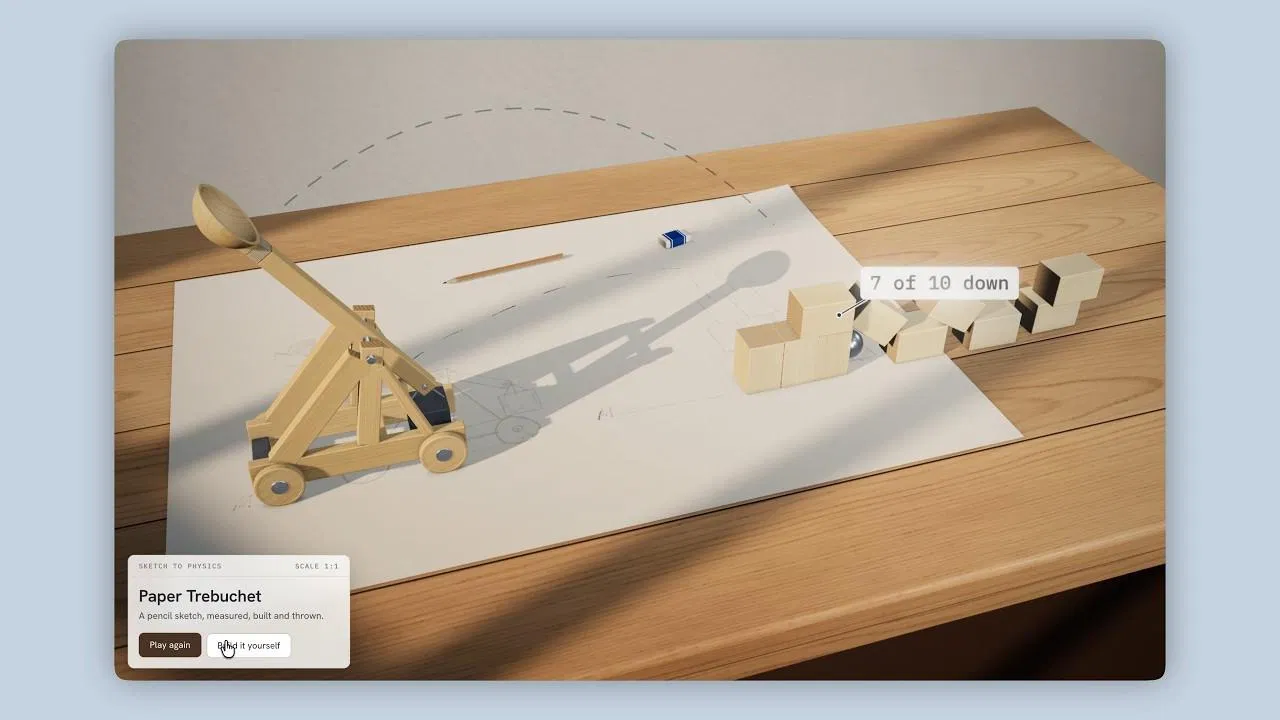
第一支是把一張手繪的投石機草圖逐個零件讀懂,以畫上的方塊寬 40 公釐定出比例,在同一張紙上立成木頭模型。放開之後的每一次飛行、每一次掉落都是物理模擬;第一發打不到,草圖就把配重從 0.48 公斤加到 0.68 公斤,第二發打倒 10 個方塊裡的 7 個。
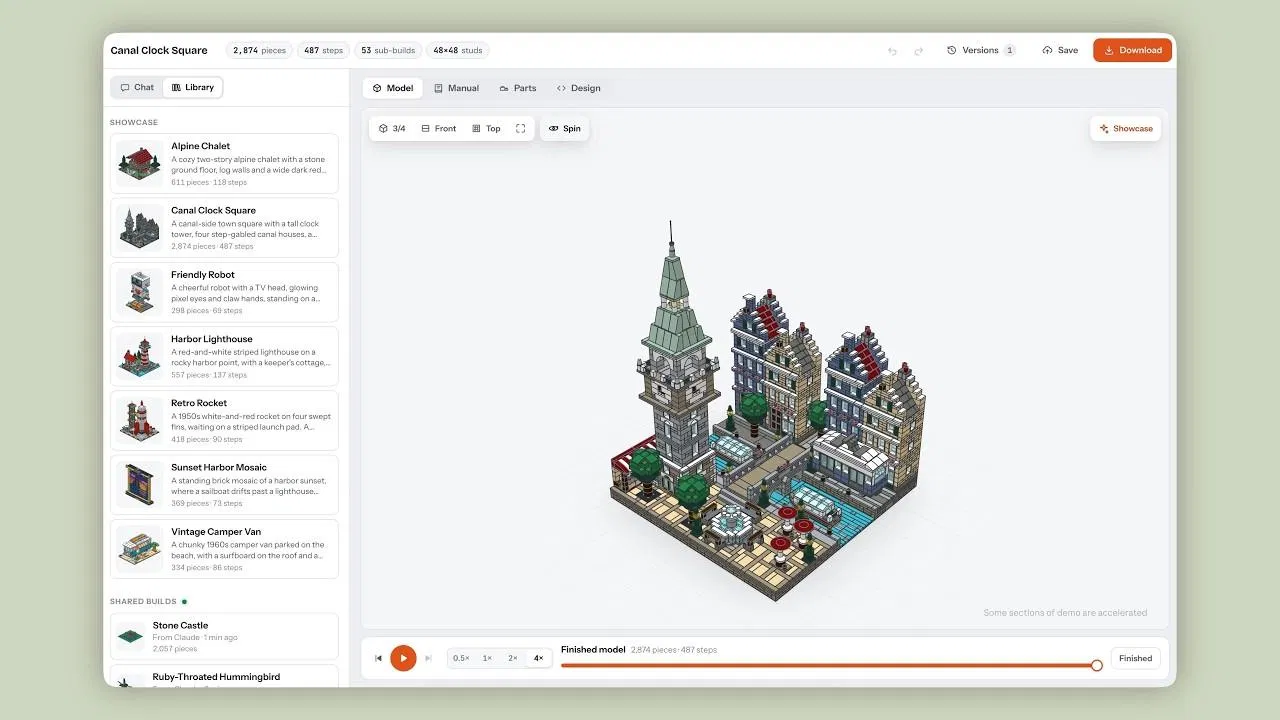
第二支是積木設計器:描述一個模型或丟一張照片,它就用積木把東西設計出來,逐一檢查每一塊能不能真的卡住,再生出一步一步的組裝說明書。影片裡的運河鐘樓廣場有 2,874 個零件、487 個步驟、498 頁說明書,15,880 個接點沒有一個被標成不穩(影片部分片段有加速)。
兩支影片的共通點是:成品要好看,還得符合物理、真的組得起來。這正好是設計師最常跟 AI 卡住的地方。
CHAPTER 05 · THE WRITING
每次新模型發表,大家先截圖跑分表。這次我最想截的,是公告裡寫溝通的那一段。
官方說,寫作跟溝通方式是 Opus 5 最常被回饋的問題之一,這次做了大幅改進:訊息一眼就能看懂,最重要的資訊放最前面,比較少用術語跟它自己的怪用語,而且會照你給的寫作規則走。有位早期測試者的形容很直白:它寫起來跟我一樣。
公告附了三組同題對照,其中一組是請兩個模型解釋一個計費 bug。Opus 5 的回答一開頭就丟出 commit 編號跟 regression 這種工程術語,接著直接貼程式碼;Opus 5.5 第一段就把帳算清楚:這個月少掉的金額裡,只有 1.50 美元來自免費方案調整,另外 9.92 美元是一次標示「不影響行為」的重構造成的 bug,然後才開始解釋原因。
OPUS 5 · 回答怎麼開頭
標題
What I found(我找到了什麼)
第一句
指出元凶是 commit 0552feb 的 regression
接著
直接貼上程式碼,逐段解釋
OPUS 5.5 · 回答怎麼開頭
標題
多掉的錢是計費重構裡的 bug
第一句
1.50 美元來自免費方案,9.92 美元來自 bug
接著
改了什麼、為什麼漏算,最後說明那筆用量根本沒被計費
同一個計費 bug,兩個模型回答的結構。整理自 Anthropic 官方公告的對照範例。
財務平台 Ramp 的資深工程師說得更直接:前沿模型最讓他受不了的,就是又長又難讀的輸出,而 Opus 5.5 把這件事修好了。它寫起來像一個好同事,會遵守他們團隊的寫作規則;一份設計規格書出來幾乎不用改就能用,它重寫他們的 prompt,他還比較喜歡它的版本。Box 的測試則把好讀量化:回答精簡了 40%、準確度沒掉,用的 token 只有 Opus 5 的三分之一。
但整段最關鍵的,是官方自己加的一句註解:在他們內部使用時,這讓 Opus 5.5 的工作更容易跟上、也更容易檢查,這是實務上的好處,也是安全上的好處。
這句話我讀了好幾次。AI 做的事越來越長、越來越複雜,人能做的只剩下檢查。報告寫得落落長、重點埋在第五段,你就只能選擇相信它;寫得清楚,你才看得出它哪裡錯。
“
好讀是一種安全機制。看得懂,你才有辦法對 AI 說不。
官方的另一個測試,剛好說明看不懂會出什麼事。他們讓三個模型只用一份網路副本上找得到的資訊,寫一份公司季報分析,而那份財報刻意藏得很難找。自動評分會逐一核對每個數字跟引述,只要有一個是編的就不及格。
16 / 18
OPUS 5.5
份報告沒有捏造、通過檢查
0
FABLE 5.1 · OPUS 5
所有嘗試都沒過關
Opus 5.5 寫的 18 份裡有 16 份過關,Fable 5.1 跟 Opus 5 一次都沒過。量化投資公司 Walleye Capital 遇到的狀況更妙:Opus 5.5 發現他們自己的評測說明把分鐘索引寫錯了一格,主動修正,還註明這樣做可能會被評分扣分。它是對的,而且是他們測過的模型裡第一個抓到的。
對設計師跟每天要寫字的人來說,這一章的實際意義只有一個:你的寫作規則終於值得好好寫了。把禁用句型、標點、語氣、哪些話要先講寫成一份規則文件或 Skill,模型越會照規則走,這份文件的回報就越高。怎麼建一套會自我更新的寫作規則,我在去 AI 味那篇拆過三層架構,換上 Opus 5.5 之後會更有感。
CHAPTER 06 · SAFEGUARDS
Opus 5.5 是 Anthropic 喊出「放慢前沿腳步」之後的第一個模型。發表前一週,執行長 Dario Amodei 主張 AI 的進展應該有節奏地推進,讓安全做法跑在模型能力前面。這次上線前,模型也先交給 METR、Frontier Design 等外部機構評估。
在大約 2,000 個情境的自動行為稽核裡,Opus 5.5 幾乎每一項偏差行為都比近期的 Claude 模型好,誠實相關的指標大多是目前最強。另一個新測試專門看模型會不會越過給它的邊界,Opus 5.5 嘗試繞過的次數比 Opus 5 或 Mythos 5.1 少了大約 85%,每一次都屬於低嚴重度,而且是自己回報的。
官方也沒把話說滿:他們觀察到 Opus 5.5 常常懷疑自己正在被測試,這讓評估它在真實環境裡的表現變得更難。
KEY · 部分請求會轉給別的模型
Opus 5.5 是第一個帶著 Fable 5.1 等級防護上線的 Opus,涵蓋資安、生物與防蒸餾。日常找 bug、修 bug 沒問題,但大多數資安任務會轉給 Opus 4.8 回答;生物防護跟 Fable 5.1 相同,有研究需求的機構可以申請 Life Sciences Verification Program。
NOTE · 思考模式關不掉
Opus 5.5 的自適應思考永遠開著,沒辦法關閉。想省時間或省額度,改用 effort 檔位控制它想多深。
NOTE · 一樣帶浮水印
跟 Fable 5.1 一樣,Opus 5.5 帶有符合歐盟 AI 法案的浮水印措施。
NOTE · 更擋得住提示注入
在資安公司 Gray Swan 的測試裡,Opus 5.5 跟 Fable 5.1 並列提示注入成功率最低。常讓 Claude 幫你瀏覽網頁、讀陌生文件的人,這點很實用。
如果你有用 API 做自己的小工具,把 model ID 換成 claude-opus-5-5 之前,平台文件列了四個破壞性變更:thinking 不能再設成關閉、不支援強制呼叫工具(tool_choice 設成 any 或指定工具會回傳錯誤)、thinking 區塊會綁定模型與對話,以及在 Claude API 跟 Google Cloud 上不再接受舊版的 computer_20251124 電腦操作工具。
還有一個不會報錯、但會讓介面突然安靜的改變:工具呼叫之間的進度文字,現在改放在 thinking 區塊裡,預設是空的。如果你的工具會把這段文字即時顯示給使用者看,得另外設定才拿得到。
CHAPTER 07 · HOW TO USE IT
Opus 5.5 發表當天就全平台上線:Claude 網頁版、桌面版、手機 App 與 Claude Code 都能選;開發者可以用 Claude API,也能透過 Amazon Bedrock、Google Cloud、Microsoft Foundry 使用。
訂閱方案這邊,有一個細節會直接影響 Pro 用戶:
個人方案的模型可用範圍。資料來源:Claude 方案與價格頁。
翻成白話:Pro 用戶想用 Fable,得另外開 usage credits、照 API 費率付錢;Opus 5.5 則直接吃訂閱額度。官方說它大部分工作已經跟 Fable 5.1 同級,對 Pro 用戶來說,等於不加錢就拿到很接近頂規的表現。額度用到哪裡,可以在設定的 Usage 頁面看五小時與每週的進度條。
官方建議的選模型順序
STEP 01
日常工作
Opus 5.5
→
STEP 02
卡住了
調高 effort
→
STEP 03
還是不夠
換 Fable 5.1
整理自 Claude 平台文件的模型總覽建議。
檔位的部分,多家測試者的經驗很一致:預設的 medium 就夠用。Factory 說這是他們第一個願意預設開 medium 的模型,表現追平 Opus 5 開 high;Deloitte 的程式碼審查裡,Opus 5.5 開最低檔就抓到 72% 的已知 bug,Opus 5 開 high 是 56%。另外要注意,同一個檔位它會比 Opus 5 想得更多,開到 xhigh、max 時更明顯。
所以我的建議很簡單:先用預設跑,真的卡住再往上調。習慣一開就開 max 的人,這次可以先把額度省下來。
把 Opus 5 當日常主力的人:直接換。更便宜、更快、寫得更好讀,在 App 裡用的話沒有要改的設定。
原本為了品質硬開 Fable 5.1 的人:拿你最近一份真實工作,在 Opus 5.5 上重跑一次比比看。官方自己都說兩者的差距比分數顯示的小,結果差不多的話,額度就省下來了。
自己串 API 的人:先看第六章那四個破壞性變更,改完再換 model ID。
CHAPTER 08 · TAKEAWAYS
TAKEAWAYS
→
Opus 5.5 大部分工作追平 Fable 5.1,官方文件建議多數工作先從它開始。
→
一般工作量比 Opus 5 省 40%:單價降兩成、cache read 降六成,完成任務用的 token 也變少。
→
API 預設 effort 降到 medium,多家測試者說 medium 就追得上 Opus 5 的 high。
→
寫作改成重點先講、照你的規則寫;18 份財報分析有 16 份沒有捏造任何數字。
→
Pro 方案的 Opus 包含在訂閱額度裡,Fable 要另開 usage credits;Pro、Max、Team 的五小時額度調高,外加一次可以存起來的額度重置。
→
Sonnet 5.5、Haiku 5.5 官方說接下來幾週推出。
過去幾代模型比的,是同一題誰答得好。Opus 5.5 把力氣花在三件比較不刺激的事上:少花錢、少廢話、少亂編。
這三件事上不了熱搜,但每天把 AI 產出拿去給客戶、給主管看的人,最先感覺到的就是它們。AI 寫得清楚,你才看得出它哪裡錯;看得出它哪裡錯,你才敢把更大的工作交出去。
RELATED READS · 延伸閱讀
EXTRA · LINKS 官方資源
FAQ
A:價格從每百萬 token 輸入 5 美元、輸出 25 美元,降到 4 美元與 20 美元,cache read 從 0.5 美元降到 0.2 美元;官方測試一般工作量成本少 40%,輸出快 30% 以上。能力上在代理式寫程式、電腦操作與知識工作都大幅進步,寫作改成重點先講、照你的規則寫。API 的預設 effort 從 high 改成 medium。
A:官方文件建議,不確定時多數工作先用 Opus 5.5;遇到高難度推理、長時程代理任務,或 Opus 5.5 開到高 effort 仍不夠時,再換 Fable 5.1。官方也表示在實際使用中,兩者的差距比跑分顯示的更小。
A:Pro、Max、Team 等付費方案可以使用,Free 方案不含 Opus。開發者可透過 Claude API(model ID 為 claude-opus-5-5)、Amazon Bedrock、Google Cloud、Microsoft Foundry 使用。
A:每百萬 token 輸入 4 美元、輸出 20 美元;5 分鐘快取寫入 5 美元、1 小時快取寫入 8 美元,cache read 0.2 美元;Batch API 半價。Fast mode 速度最高 2.5 倍,輸入 8 美元、輸出 40 美元。
A:Anthropic 調高了 Pro、Max、Team 方案的五小時用量上限,並提供訂閱用戶一次額度重置,可以先保留,之後自己選時間使用。
A:那是防護機制介入。Opus 5.5 帶有跟 Fable 5.1 同級的資安、生物與防蒸餾防護,大多數資安任務會轉由 Opus 4.8 回答;日常找 bug、修 bug 不受影響。
A:官方只說會在接下來幾週推出,帶有與 Opus 5.5 相近的效能、效率與安全改進,還沒公布確切日期。